PhyEdit: chỉnh sửa ảnh hiểu đúng vật lý 3D, không còn "dán" vật thể sai tỉ lệ
Thử yêu cầu một công cụ chỉnh sửa ảnh AI “đẩy chiếc card đồ hoạ ra gần camera hơn” hay “di chuyển cây bút tới góc dưới-trái tờ giấy” — phần lớn mô hình hiện nay sẽ dịch chuyển vật thể đúng hướng nhưng sai tỉ lệ: vật thể không phóng to đúng mức khi tiến lại gần, không xoay đúng góc theo phối cảnh, bóng đổ không khớp với vị trí mới. Bài báo “PhyEdit: Towards Real-World Object Manipulation via Physically-Grounded Image Editing” (Ruihang Xu, Dewei Zhou, Xiaolong Shen, Fan Ma, Yi Yang — ReLER Lab, Đại học Chiết Giang, ACM MM 2026) chỉ ra gốc rễ của vấn đề và đề xuất một hướng giải quyết khá trực diện: thay vì để mô hình tự “đoán” hình học chỉ từ pixel, hãy tính toán hình học tường minh và đưa thẳng vào mô hình làm ngữ cảnh.
Vì sao các mô hình chỉnh sửa ảnh hiện nay “đoán sai” hình học
Các mô hình sinh ảnh thị giác hiện đại (dựa trên kiến trúc diffusion/DiT) học cách chỉnh sửa ảnh chủ yếu từ dữ liệu 2D, không có cơ chế tường minh nào để đưa vào phép chiếu phối cảnh (perspective projection) hay cấu trúc 3D của cảnh. Kết quả là khi người dùng yêu cầu di chuyển một vật thể trong không gian 3D — đặc biệt theo trục sâu (depth axis, tức tiến/lùi so với camera) — mô hình phải tự suy luận cách vật thể đó co giãn và biến dạng, và thường suy luận sai. Đây chính là khoảng trống mà PhyEdit nhắm tới: cung cấp hướng dẫn thị giác nhận biết-3D (3D-aware visual guidance) dưới dạng mô phỏng hình học tường minh, gắn trực tiếp vào quá trình sinh ảnh.
Kiến trúc: mô phỏng hình học tường minh làm ngữ cảnh cho DiT
Thay vì yêu cầu mạng nơ-ron tự học cách vật thể co giãn theo phối cảnh, PhyEdit tính toán trực tiếp bằng hình học chiếu (projective geometry) qua một 3D Transformation Module, hoạt động theo ba bước:
- Unproj (giải chiếu): từ ảnh nguồn, mask vật thể cần chỉnh sửa và vector dịch chuyển do người dùng chỉ định, mô hình ước lượng bản đồ độ sâu (depth map) và tư thế camera (camera pose), rồi “giải chiếu” vùng vật thể thành một đám mây điểm 3D thực sự.
- Dịch chuyển trong không gian 3D: vector dịch chuyển được áp dụng trực tiếp lên đám mây điểm 3D đó — đảm bảo phép biến đổi tuân theo đúng hình học không gian, không phải một phép “kéo-thả” phẳng trên mặt phẳng ảnh.
- Proj (chiếu lại): đám mây điểm 3D sau dịch chuyển được chiếu ngược lại qua camera ban đầu, tạo ra một ảnh xem trước có căn cứ hình học (I_prev) — ảnh này thể hiện đúng kích thước, góc nhìn và vị trí mới của vật thể theo quy luật phối cảnh.
Ảnh xem trước này sau đó được đưa vào backbone DiT như một tín hiệu ngữ cảnh bổ sung (“plug-and-play 3D prior”), giúp mô hình sinh ảnh cuối cùng bám sát ràng buộc hình học thay vì tự suy đoán. Thiết kế theo dạng mô-đun gắn thêm này cũng cho phép chỉnh sửa nhiều vật thể cùng lúc trong một lượt.
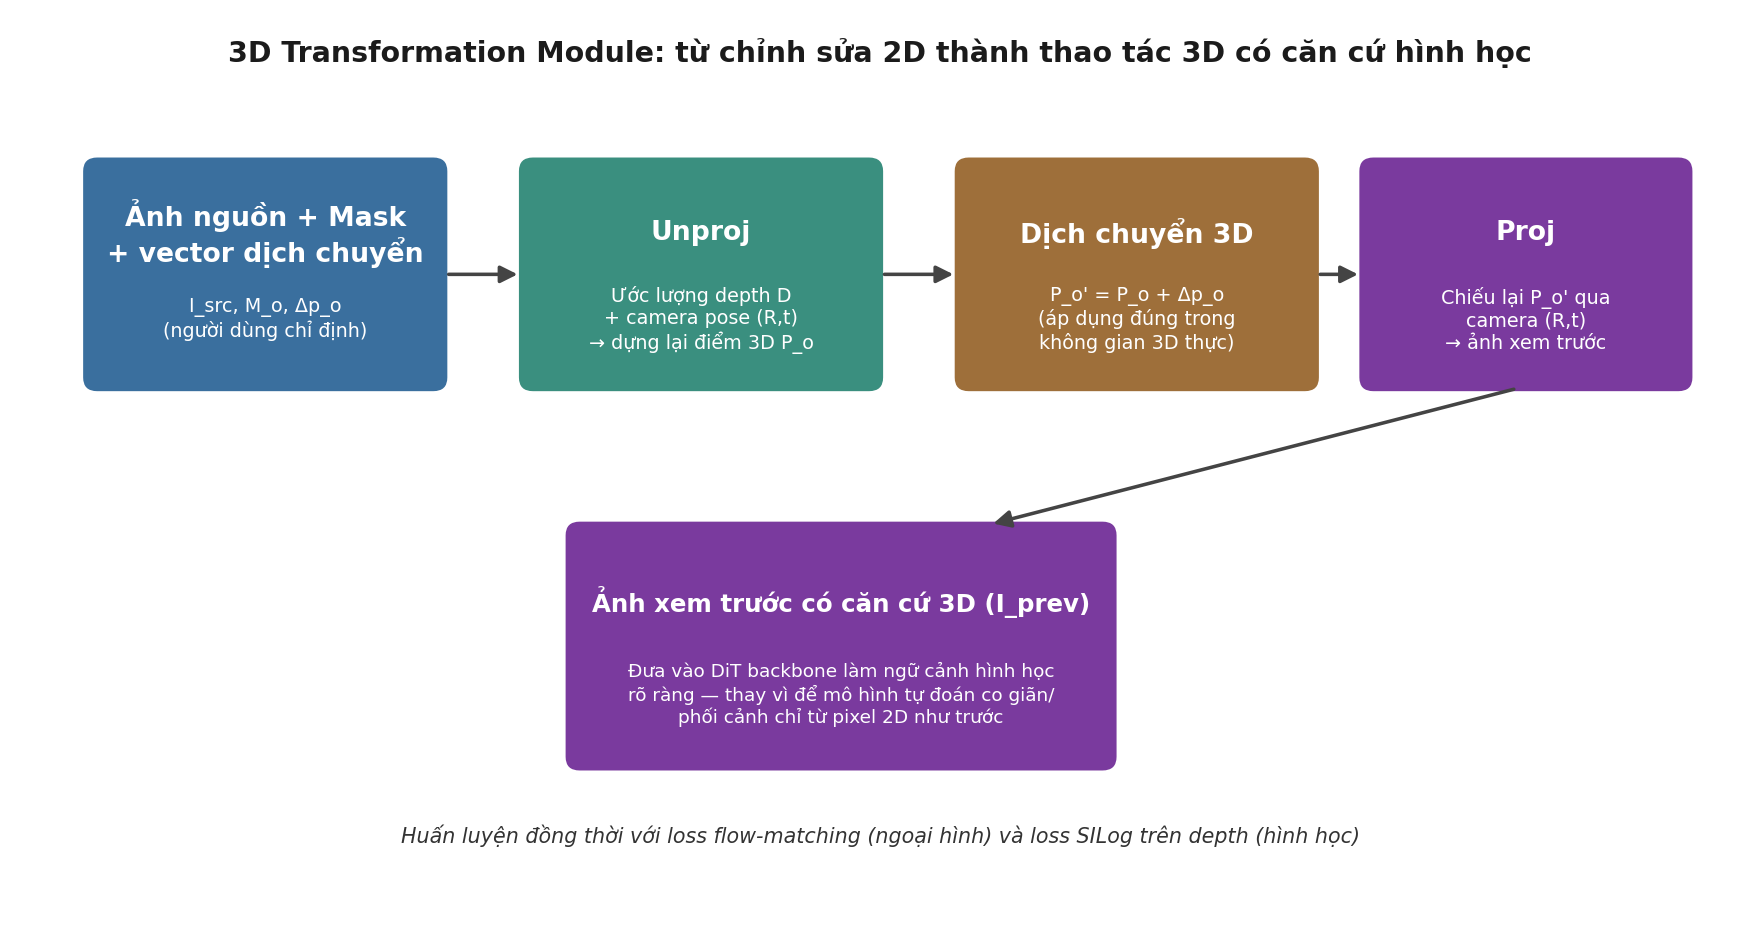
Để huấn luyện, PhyEdit kết hợp hai hàm mất mát: loss flow-matching tiêu chuẩn cho chất lượng ngoại hình, cộng thêm loss SILog (scale-invariant logarithmic) giám sát trực tiếp trên độ sâu, với trọng số phụ λ_d = 0.1. Việc bổ sung giám sát độ sâu này chỉ đòi hỏi thay đổi tối thiểu với kiến trúc DiT editor sẵn có, giúp phương pháp dễ tích hợp vào các pipeline hiện có.
RealManip-40K: bộ dữ liệu thực tế cho thao tác vật thể theo trục sâu
Một trở ngại lớn với bài toán này là thiếu dữ liệu huấn luyện phù hợp: phần lớn bộ dữ liệu chỉnh sửa ảnh hiện có chỉ ghi nhận vật thể di chuyển trong mặt phẳng ảnh (2D), không có biến đổi theo trục sâu. Nhóm tác giả xây dựng RealManip-40K — 41.154 cặp ảnh nguồn-đích thực tế có kèm chuyển động vật thể trong không gian 3D thực sự (bao gồm cả thay đổi theo trục sâu), mỗi cặp đi kèm bản đồ độ sâu, mask vật thể, và toạ độ 3D đại diện trong không gian camera.
Bộ dữ liệu được xây dựng qua pipeline 4 giai đoạn: lọc nguồn dữ liệu → trích xuất đoạn video có camera tĩnh (dùng phân cụm DBSCAN trên camera token để chọn các đoạn gần như tĩnh) → xử lý độ sâu và mask → chọn cặp khung hình theo tiêu chí nhận biết độ sâu.
ManipEval: benchmark đa chiều cho thao tác vật thể 3D
Để đánh giá công bằng khả năng kiểm soát không gian 3D, nhóm tác giả đề xuất ManipEval — benchmark gồm 9 chỉ số trải trên nhiều khía cạnh: định vị vật thể (DIoU, Mask IoU), độ chính xác độ sâu (AbsRel, δ₁.₂₅), độ khớp hình học 3D (Chamfer distance, Centroid distance), và chất lượng/tính hợp lý vật lý tổng thể (RA-DINO, DeQA, Phys-VLM).
Kết quả: vượt cả các mô hình đóng nguồn mạnh
Trên benchmark ManipEval, PhyEdit đạt kết quả tốt nhất ở hầu hết các chỉ số liên quan tới thao tác vật thể — kể cả khi so với các hệ thống thương mại đóng nguồn mạnh như GPT-Image-1.5, Qwen-Image-2.0-Pro và Nano Banana Pro.
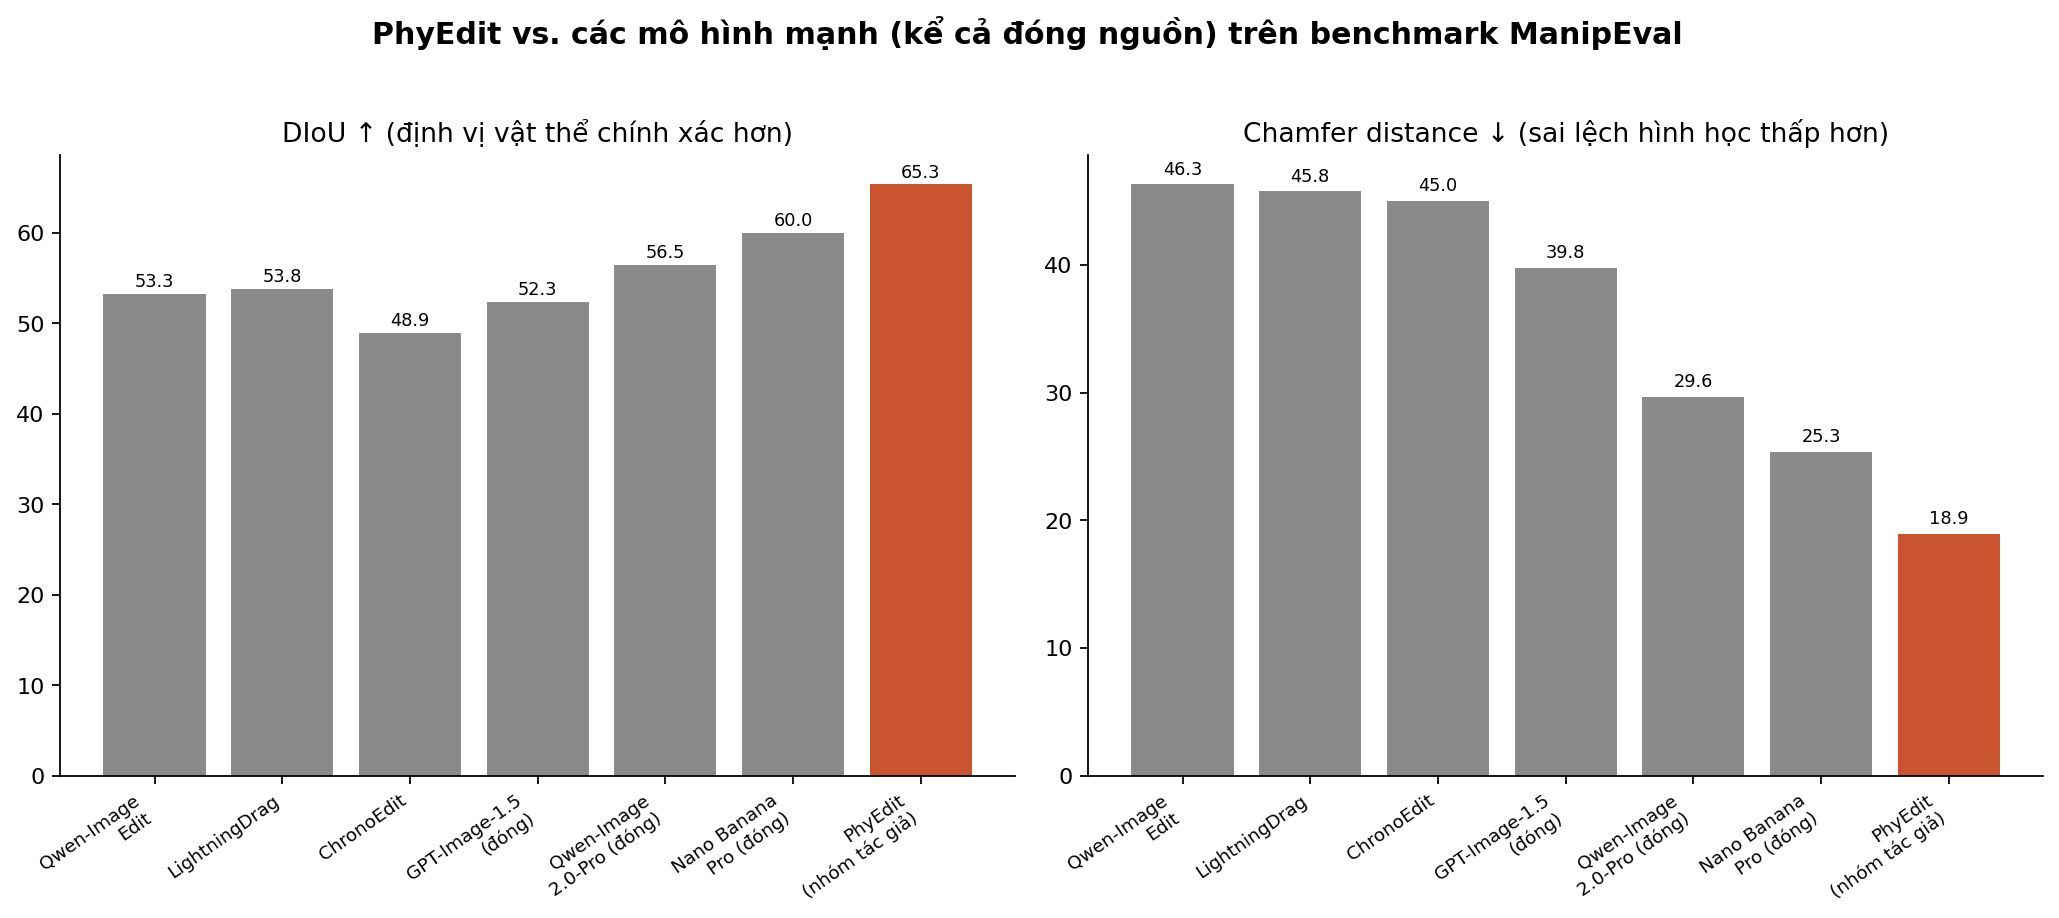
So với Nano Banana Pro — đối thủ đóng nguồn mạnh nhất trong phép so sánh — PhyEdit đạt DIoU cao hơn +5,36 điểm và Chamfer distance thấp hơn 6,40 điểm (càng thấp càng chính xác về hình học), RA-DINO cao hơn +2,14 điểm. Khoảng cách này còn nới rộng hơn trên các cảnh có nhiều vật thể cùng lúc — khoảng cách Chamfer tăng từ 5,19 lên 6,58, khoảng cách δ₁.₂₅ tăng từ 1,91 lên 8,02 — cho thấy lợi thế của việc mô phỏng hình học tường minh càng rõ rệt khi bài toán càng phức tạp (nhiều vật thể cần giữ nhất quán không gian với nhau đồng thời).
Thao tác liên tục theo quỹ đạo 3D
Ngoài chỉnh sửa một bước, PhyEdit còn hỗ trợ theo dõi một quỹ đạo 3D do người dùng định nghĩa — sinh các khung hình chính (keyframe) dọc theo quỹ đạo trong khi vẫn giữ nhất quán hình học, sau đó nội suy giữa các khung hình chính đó. Nhóm tác giả thử nghiệm với cảnh có cánh tay robot — một đối tượng nằm ngoài phân phối dữ liệu huấn luyện (out-of-distribution) — để chứng minh khả năng khái quát hoá của phương pháp.
Vì sao cách tiếp cận này đáng chú ý
Điểm đáng chú ý nhất của PhyEdit không nằm ở việc huấn luyện một mô hình lớn hơn hay nhiều dữ liệu hơn, mà ở việc định vị đúng phần việc nên giao cho hình học tường minh và phần việc nên giao cho mạng nơ-ron sinh ảnh: phép chiếu phối cảnh là toán học đã được giải quyết triệt để từ lâu (thị giác máy tính cổ điển), không cần và không nên bắt một mạng diffusion phải “học lại” từ đầu qua dữ liệu pixel. Bằng cách tách rõ hai phần này — dùng mô phỏng 3D tường minh để tạo ngữ cảnh hình học chính xác, rồi để mô hình sinh ảnh tập trung vào phần việc nó làm tốt nhất (tổng hợp ngoại hình chân thực) — PhyEdit đạt được độ chính xác hình học cao hơn hẳn so với việc phó mặc toàn bộ bài toán cho một mạng nơ-ron end-to-end, dù mạng đó có mạnh và được huấn luyện với quy mô dữ liệu đóng nguồn khổng lồ đến đâu.
Đang tải bình luận…